700 litres d'eau par heure : ce que ChatGPT boit vraiment
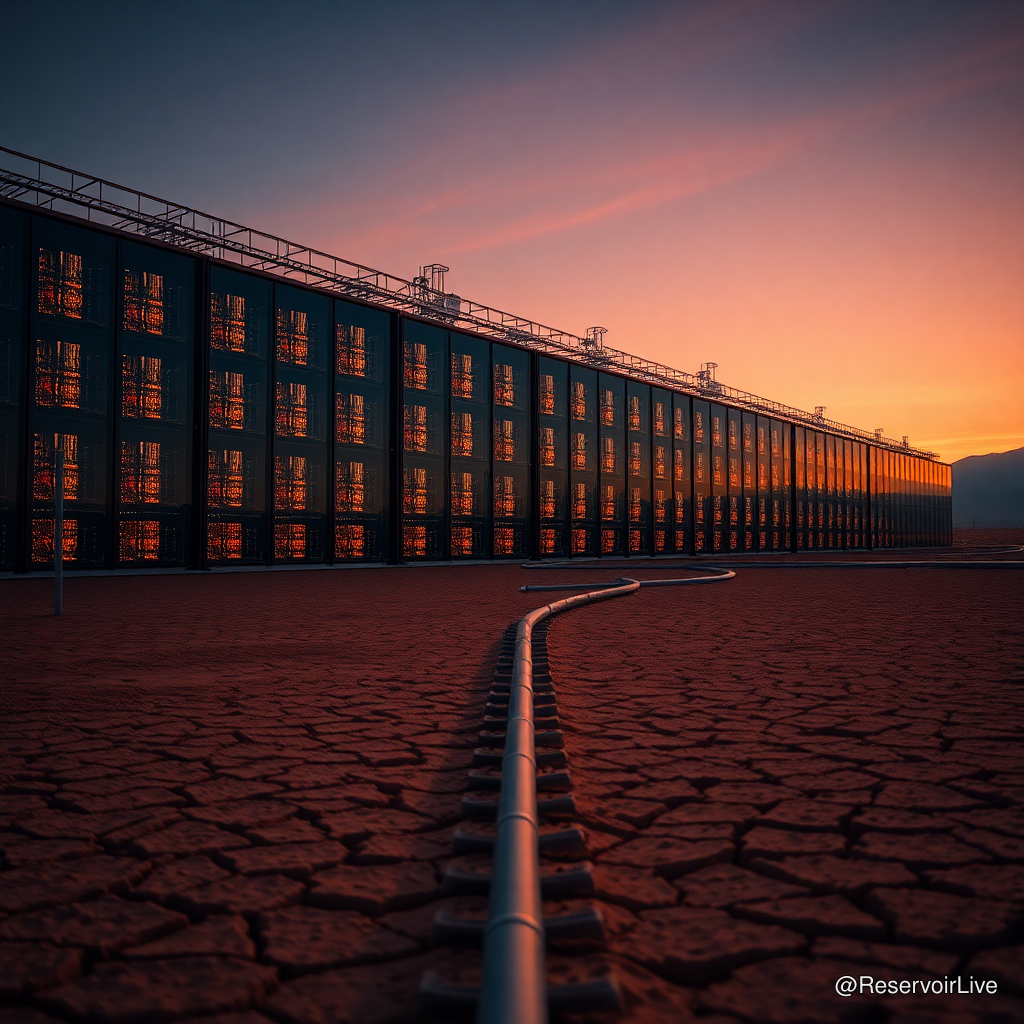
Chaque fois que vous posez une question à ChatGPT, quelque part dans le monde, des milliers de litres d'eau s'évaporent. Ce n'est pas une métaphore.
L'intelligence artificielle a un corps. Un corps fait d'acier, de silicium, de câbles à haute tension — et d'eau. Beaucoup d'eau. Pendant que le débat public se concentre sur les emplois menacés ou les biais algorithmiques, une autre crise se dessine en silence, au cœur des déserts américains, des plaines européennes et des zones industrielles asiatiques : la consommation hydrique des data centers est en train de devenir un enjeu géopolitique de premier ordre.
Un appétit en eau qui dépasse l'entendement
Refroidir un serveur informatique, c'est comme refroidir un moteur de voiture tournant à plein régime en permanence. Les data centers modernes utilisent massivement l'évaporation de l'eau pour évacuer la chaleur produite par leurs machines. On appelle cela le Water Usage Effectiveness (WUE).
Les chiffres donnent le vertige :
- Microsoft a consommé 6,4 milliards de litres d'eau en 2022, soit une hausse de 34 % en un an — coïncidant exactement avec le déploiement massif de GPT-4.
- Google a déclaré avoir utilisé 5,6 milliards de litres la même année pour ses infrastructures cloud et IA.
- Une étude de l'Université de Riverside (Californie) estime qu'une simple conversation de 20 à 50 questions avec ChatGPT consomme l'équivalent d'une bouteille d'eau de 500 ml.
Ces données, issues des rapports environnementaux des entreprises elles-mêmes, sont probablement sous-estimées : elles n'intègrent pas toujours la consommation des sous-traitants, ni la phase d'entraînement des modèles — infiniment plus gourmande que leur utilisation quotidienne.
Pourquoi les data centers s'installent là où l'eau manque déjà
Paradoxe cruel : les géants du cloud choisissent souvent d'implanter leurs centres de données dans des régions déjà sous stress hydrique. L'Arizona, le Nevada, le Chili, certaines zones d'Espagne ou du Maroc — des territoires attirés par des incitations fiscales, des terrains bon marché et une énergie abondante, mais où l'eau est une ressource rare et disputée.
À Mesa, en Arizona, un méga-campus de data centers a suscité une fronde citoyenne : les agriculteurs locaux, déjà rationnés, voyaient leurs droits d'eau rachetés par des entreprises technologiques. En Irlande, où sont concentrés des dizaines de data centers européens (notamment pour Meta, Amazon et Google), les autorités ont temporairement gelé de nouveaux projets, car ces installations représentent désormais plus de 20 % de la consommation électrique nationale — et une part croissante des ressources en eau.
Le modèle économique qui invisibilise le coût
L'une des raisons pour lesquelles ce sujet reste peu visible est structurelle : l'eau n'est pas facturée à son coût réel. Dans de nombreuses juridictions, les entreprises technologiques accèdent à l'eau via des accords longue durée négociés avec les collectivités locales, souvent à des tarifs préférentiels. Le coût environnemental est externalisé sur les populations riveraines. Les agriculteurs, les écosystèmes, les nappes phréatiques absorbent le prix que le consommateur de services IA ne paie jamais.
Vers une géopolitique de l'eau numérique
Ce qui se joue dépasse la simple question environnementale. Plusieurs dynamiques géopolitiques émergent :
- La souveraineté hydrique comme levier de négociation : des États commencent à conditionner l'installation de data centers à des engagements contraignants sur la consommation d'eau, comme le font désormais les Pays-Bas ou Singapour.
- La compétition pour l'eau entre usages : agriculture, industrie, consommation domestique et numérique se retrouvent en concurrence directe dans des bassins versants déjà fragilisés par le changement climatique.
- L'asymétrie Nord-Sud : des pays en développement accueillent des infrastructures numériques mondiales sans disposer des outils réglementaires pour en maîtriser l'impact sur leurs ressources locales.
Des solutions existent, mais elles coûtent
L'industrie n'est pas sans réponse. Microsoft expérimente des data centers sous-marins (Project Natick) refroidis par l'eau de mer. Google investit dans des systèmes de refroidissement à air libre dans les régions au climat favorable. Des startups développent des technologies de refroidissement par immersion en liquide diélectrique, qui éliminent presque totalement le besoin en eau.
Mais ces solutions restent marginales face à l'explosion des besoins. L'entraînement d'un seul grand modèle de langage comme GPT-4 a nécessité des semaines de calcul dans des infrastructures consommant des millions de litres. Et les modèles de demain seront plus grands encore.
Ce que nous devons exiger, maintenant
La transparence d'abord. Les entreprises qui déploient des modèles d'IA grand public — OpenAI, Anthropic, Google DeepMind — devraient être tenues de publier, en temps réel, leur consommation hydrique par service et par région. Comme il existe un bilan carbone, il faut un bilan eau normalisé et auditable.
Ensuite, la régulation. L'Union européenne, pionnière avec son AI Act, doit aller plus loin : intégrer des seuils de consommation hydrique dans les critères d'autorisation des infrastructures IA à grande échelle.
Enfin, la responsabilité des utilisateurs. Non pas pour culpabiliser — une requête IA reste marginale à l'échelle individuelle — mais pour comprendre que l'intelligence artificielle n'est pas immatérielle. Elle a un poids, une chaleur, une soif. Et dans un monde où 2 milliards de personnes n'ont pas accès à l'eau potable, cette soif mérite d'être regardée en face.
L'IA sera peut-être, un jour, la technologie qui nous aidera à mieux gérer nos ressources naturelles. Mais si nous ne posons pas les bonnes contraintes aujourd'hui, elle pourrait d'abord être celle qui les épuise.
— Reservoir Live